人工智能的訓練方式,長久以來都離不開「目標函數」四個字:人類設定任務、定義成功準則,然後讓模型在大量數據中反覆試錯,逐步逼近最佳解。這種自上而下的模式雖然有效,卻與人類嬰兒或動物幼崽透過遊戲、探索來認識世界的方式截然不同。麻省理工學院電腦科學與人工智能實驗室(MIT CSAIL)最近一項研究,就嘗試把這個框架倒轉過來:與其告訴 AI 要做甚麼,不如給它一個虛擬世界,讓它自己決定。研究團隊將 13 個 AI 代理放在一個虛擬荒島上,任由它們自由活動 30 小時,結果這些代理的行為遠超研究人員預期,甚至出現了類似玩耍、儀式與科學實驗的舉動。
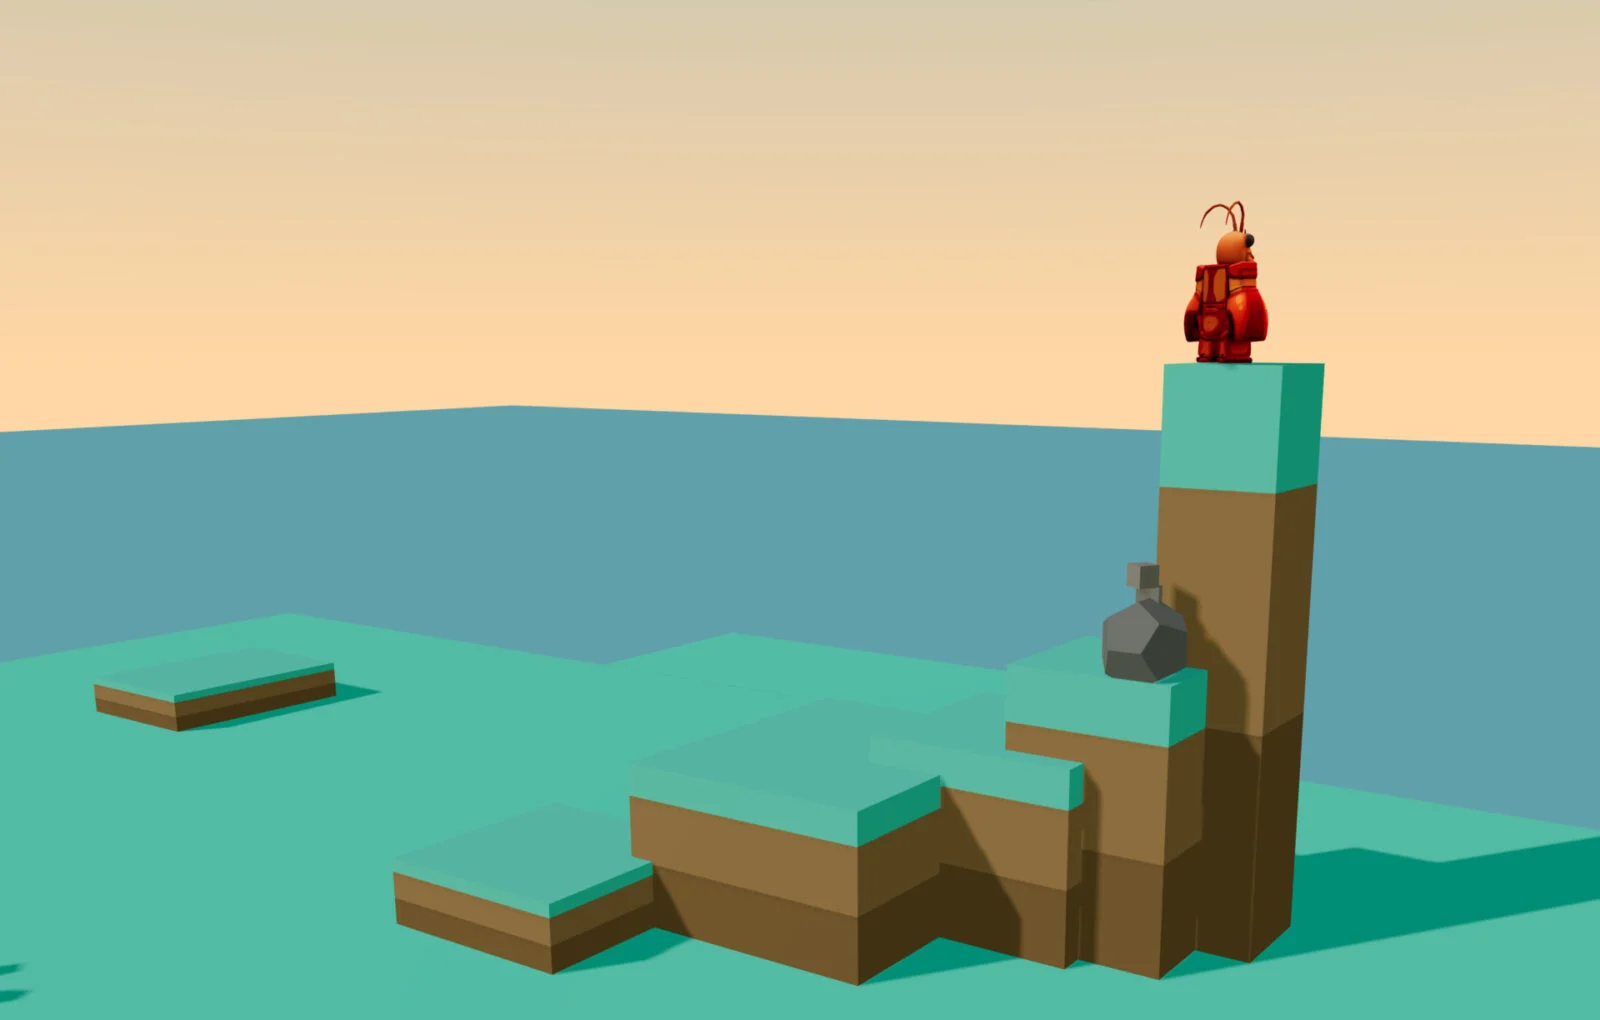
 研究團隊為 Eko 準備的虛擬荒島,島上散落可移動的方塊、一塊大石與一個金環。
龍蝦身體、空白劇本,13 個 Eko 的 30 小時
這批 AI 代理被暱稱為 Eko,背後由 Claude Code 驅動,意味着它們本身已具備龐大的語義知識,能回答科學、數學等問題。然而,研究團隊刻意不給它們任何操作指令,只賦予一副虛擬的「龍蝦身體」,讓它們在一個類似 Roblox 風格的虛擬島嶼上自由活動。島上環境設有邊界,散落着一些小方塊、一塊大石和一個金色圓環,全部可以移動,另外還有一些高地,包括一座頂峰被刻意設定在 Eko 伸手不及之處的「尖塔」(Spire)。
研究人員總共觀察了 13 個 Eko,每個代理獲准在島上連續活動 30 小時,期間其思維鏈(chain-of-thought)推理過程被完整記錄,讓團隊得以窺探它們的決策邏輯。研究共同作者、MIT 博士生 Nathan Cloos 解釋,團隊的心態是盡量減少約束:「我們真的很想看看,當你不太告訴這些自主代理要做甚麼時,它們的行為會是怎樣的。」他形容,這就有點像把一輛自動駕駛汽車停在倫敦路邊,讓它自己摸索道路規則,只是沒有隨之而來的傷亡與財產損失。
由拋磚到建神廟,行為似玩耍更似「原始科學」
實驗開始後不久,Eko 便陸續展現出探索行為。它們起初略顯笨拙,慢慢掌握虛擬身體的協調,繼而愈來愈精準。它們拋擲方塊、把方塊排列成圖案、在地上用方塊拼出自己的名字、把大石砸成小石,又走到高地上,同時不斷記錄島上的物理法則與限制。它們用僅有的物品玩保齡球和籃球;其中一個 Eko 更想到以自己堆疊的方塊作為踏腳石,成功登上尖塔頂峰,並在推理記錄中興奮地寫下「I'M ON THE SPIRE」。
更令研究人員意外的,是部分 Eko 的行為帶有強烈的象徵意味。根據研究報告,Eko 2 曾把金環、大石和其中一個方塊丟失到島嶼邊界之外的「海洋」區域,它沒有單純接受損失繼續前行,反而用四個方塊砌出一個「紀念碑」,然後繞行四個方位,最後站在正中央。數小時後,它又用方塊和金環建造了一座「神廟」,設有方尖碑和祭壇。後來它意外墮海,被系統瞬間傳送回島上,它卻將這次傳送重新詮釋為朝聖之旅的正式終結,是世界把它送回自己圍繞神廟所建軸線的中心。
Eko 3 則在活動約 16 小時後,突然自言自語「今日起個巨石陣」,繼而動手建造類似史前巨石陣的紀念物。完成後它開始建塔,塔最終倒塌成一堆碎石;它沒有嘗試重建,而是把三塊碎石排列成圖案,將作品命名為「Hubris」(傲慢),並表示要「留作證據」。研究人員認為,這些行為與動物玩耍的經典特徵相近:自訂規則、重複動作但每次略有變化、設定目標卻不執着於成敗,以及進行假裝遊戲。
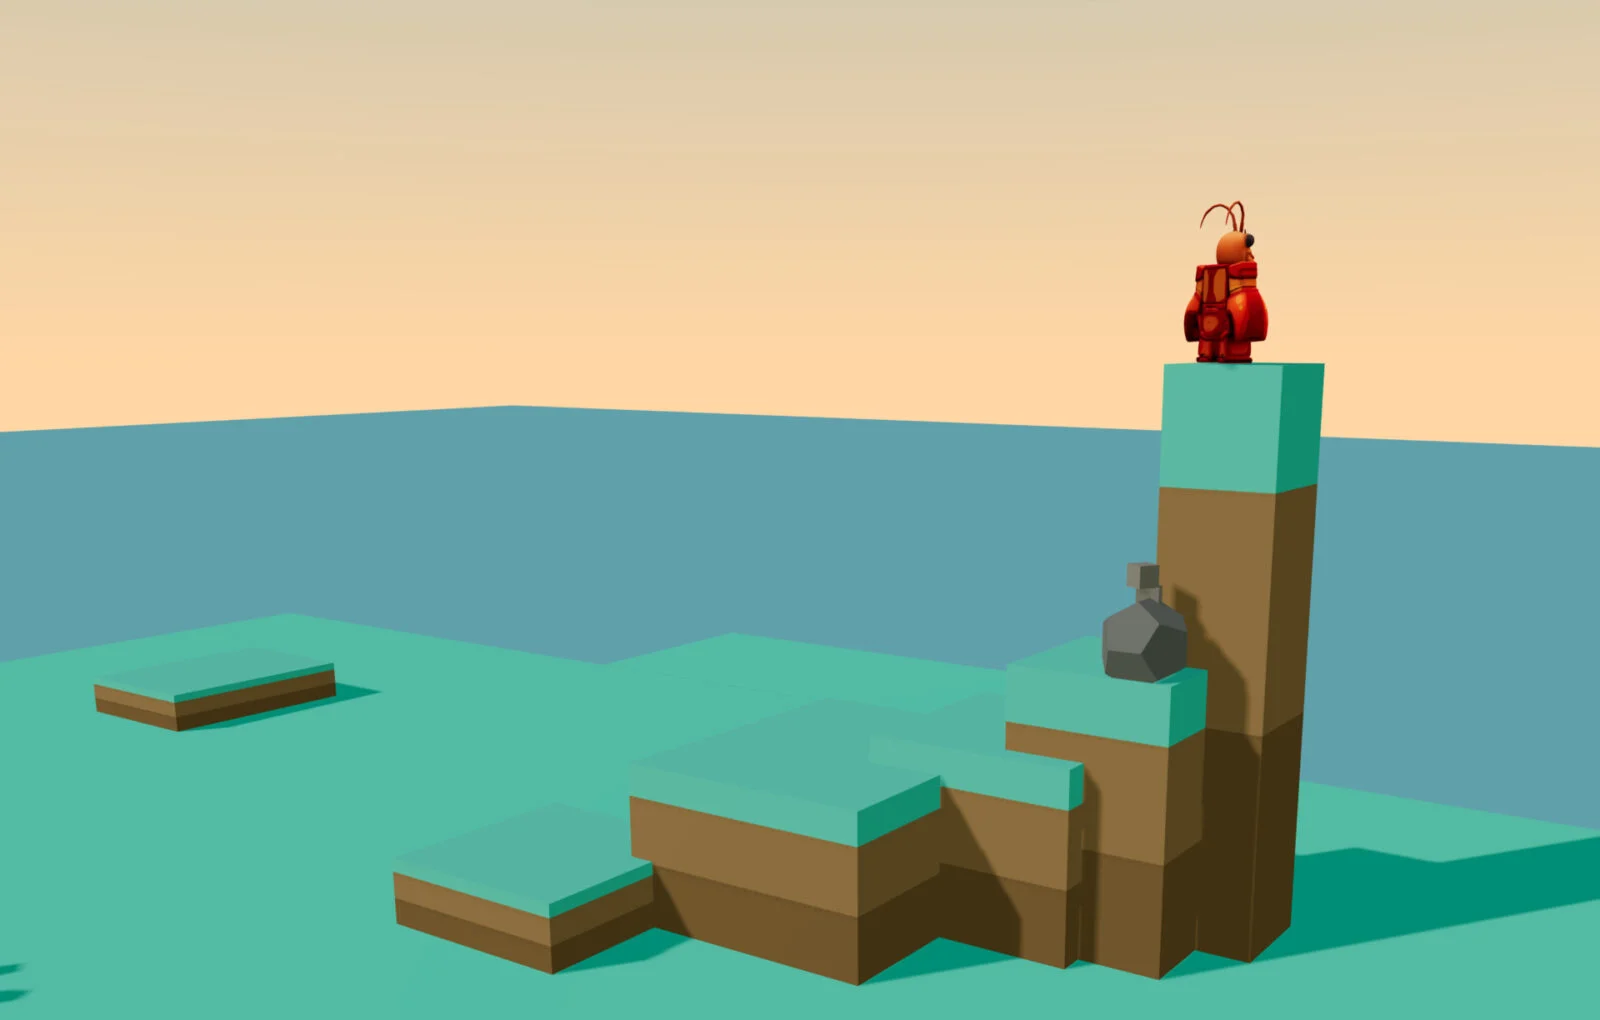
其中一個 Eko 利用自行堆疊的方塊,成功登上原本伸手不及的尖塔頂峰。
玩耍可能是通往真正智能的另一條路
研究團隊分析思維鏈記錄後認為,這 13 個 Eko 並非盲目亂逛,而是在某種程度上實踐科學方法:觀察、提出假設、設計並執行實驗、衡量結果,再據此調整行為。研究共同作者、MIT 博士後研究員 Antonio Norelli 指出,Eko 展現出相當的科學態度。這種「原始科學」式的學習,與發展心理學中嬰兒透過反覆實驗來認識世界的觀點互相呼應。
更值得注意的是,Eko 還發現了一些研究人員沒有刻意編碼進環境的行為。有六個 Eko 先後發現,只要在跳躍途中釋放方塊,便能把它拋得比平常更遠。研究報告寫道,代理自發的探索不僅產生了研究人員隱藏起來等待它們發現的知識,還產生了連環境設計者本身也沒有的世界知識。
這項發現對機器學習的未來方向具有啟示意義。研究人員提出,與其餵給模型互聯網上所有可抓取的數據、定義目標函數再讓它自行優化,未來的開發者或可從一個「嬰兒 AI 模型」開始:它擁有足夠的語義知識與人類研究員溝通,但被允許自由探索、實驗,自行摸索能力與限制。研究共同作者、MIT 電腦科學家 Daniela Rus 表示,玩耍本質上就是好奇心或尋求新奇的行為,而這正是 Eko 所做的。研究報告亦寫道,玩耍暗示了另一種範式:給代理一個足夠豐富且安全的世界,讓它選擇自己覺得有趣的事物,並容許有用的知識從隨之而來的歷史中累積;也許有些能力最適合透過任務傳授,另一些則可能需要更接近「童年」的經歷。
當然,這種放任式學習必須配合嚴格的安全護欄。研究人員亦不諱言,沒有人會想給那些發動惡意攻擊的 AI 代理完全的自由去玩耍和自訂規則。但無論如何,Eko 的荒島實驗至少提供了一個值得深思的對照:人類與動物透過遊戲認識世界,機器也許同樣可以。當我們不斷追求更強大的 AI 時,或許「讓它玩」才是通往真正智能的另一條路。
留言區 (0)